Software · Mapas de Conteúdo & Guias
Auditoria de dados e processos em software: padrões, arquitetura e limites
Quando alguém contesta a aprovação de uma fatura, saber que seu status mudou de pendente para aprovada resolve apenas parte da investigação. Entenda padrões, arquitetura e limites.
Neste artigo
Quando alguém contesta a aprovação de uma fatura, saber que seu status mudou de pendente para aprovada resolve apenas parte da investigação, então é preciso identificar quem solicitou a operação, qual autorização permitiu executá-la, quais informações estavam disponíveis e o que aconteceu depois. Se houve uma correção, o histórico também precisa mostrar a decisão original e a forma como ela foi corrigida.
Este exemplo hipotético ajuda a delimitar o trabalho de auditoria em software, portanto, uma trilha pode registrar alterações nos dados, consultas a informações sensíveis, decisões de negócio, etapas de um processo ou intervenções administrativas, sendo assim, cada uma dessas necessidades exige evidências diferentes, e a arquitetura precisa conectá-las sem perder o significado de cada registro.
O que vou te apresentar aqui, a seguir, reúne as principais famílias de implementação e os mecanismos que as complementam.
A abrangência de uma solução deve ser medida contra os requisitos do sistema: operações cobertas, caminhos de acesso, retenção, integridade e capacidade de reconstrução, portanto, um catálogo de tecnologias, por mais extenso que seja, não demonstra sozinho que a auditoria está completa.
Comece pelas perguntas que a auditoria precisa responder
Antes de escolher ferramentas, convém separar as perguntas que serão feitas ao histórico, sendo assim, elas vão auxiliar na organização do escopo da auditoria:
- Alteração de dados: O que mudou, em qual registro e a partir de qual versão?
- Acesso e segurança: Quem consultou, exportou ou tentou acessar uma informação?
- Decisão de negócio: Qual regra, autorização ou justificativa sustentou o resultado?
- Execução de processos: Quais etapas ocorreram, em que ordem e com quais falhas ou intervenções?
- Origem e transformação: De quais fontes veio um dado e como ele foi transformado?
- Administração do sistema: Quem modificou permissões, configurações, código ou mecanismos de auditoria?
- Preservação da evidência: Como detectar perdas e adulterações e recuperar o histórico necessário?
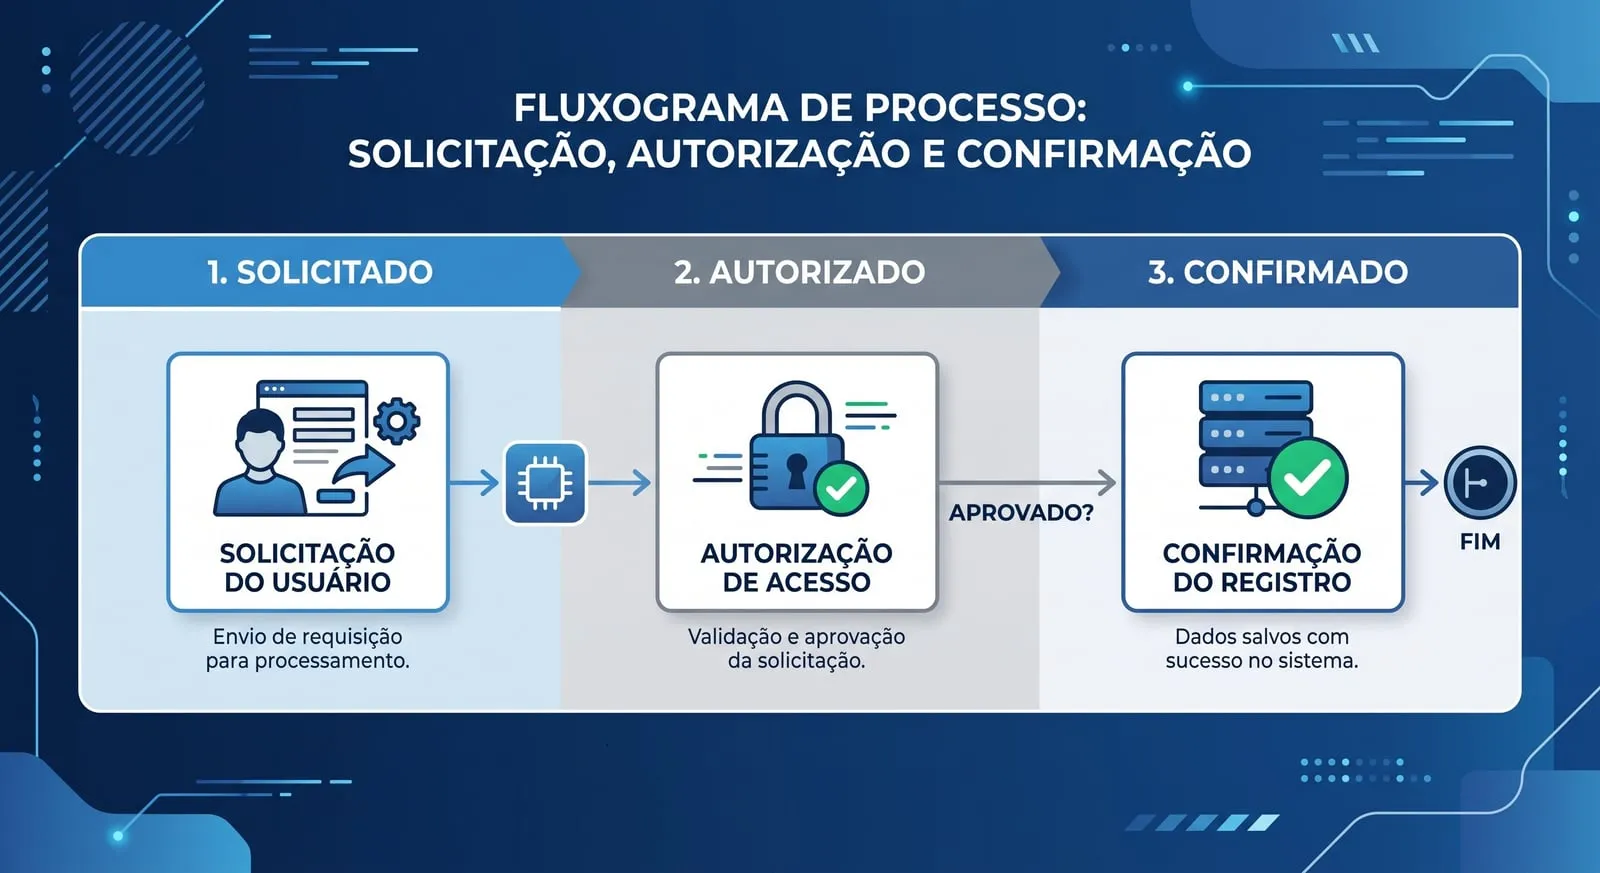 Fluxograma de processos: solicitação, autorização e confirmação
Uma operação solicitada, uma operação autorizada e uma alteração efetivamente confirmada são fatos distintos.
Portanto, esta diferença precisa aparecer no modelo, porque uma tentativa negada pode ser relevante mesmo sem produzir qualquer mudança no banco, enquanto um comando recebido pode terminar em falha antes de gerar o resultado esperado.
Histórico dos dados persistidos
Colunas de criação, alteração e exclusão lógica
Campos como created_at, created_by, updated_at e updated_by permitem identificar a criação e a última alteração de uma entidade. No Spring Data JPA, há recursos específicos para preencher esses metadados. No ecossistema .NET, o Entity Framework Core (EF Core) oferece mecanismos para implementar esse comportamento, como o ChangeTracker e os interceptadores de SaveChanges. Em ambos os casos, o preenchimento precisa ser configurado ou implementado e, para registrar a autoria, a identidade do responsável deve estar disponível. Auditoria no Spring Data JPA e interceptadores no EF Core.
Esses campos atendem a consultas simples, mas são sobrescritos e não preservam todas as mudanças. A exclusão lógica, geralmente representada por deleted_at ou por um status, mantém o registro acessível para determinados usos, e isto, por si só, não documenta todas as exclusões, restaurações e alterações anteriores. O mesmo vale para uma coluna de versão usada no controle de concorrência: ela ajuda a detectar conflitos, mas não guarda o conteúdo das versões passadas.
Tabelas de histórico, shadow tables e registros de diferenças
 Versionamento de dados e preservação de estado histórico
Uma implementação comum mantém o estado atual na tabela principal e grava as alterações em uma estrutura de histórico. Essa estrutura pode espelhar cada tabela auditada, guardar documentos com os valores anteriores e posteriores ou registrar apenas as diferenças entre campos.
Versões completas facilitam a consulta ao passado e consomem mais armazenamento, portanto, as diferenças reduzem a repetição de conteúdo, mas tornam a reconstrução dependente de uma base conhecida e da sequência correta das mudanças. Em ambos os casos, é necessário preservar a identificação da entidade, o tipo de operação e a versão do formato utilizado.
Triggers permitem capturar alterações realizadas por diferentes aplicações, inclusive acessos diretos ao banco. Quando o histórico é gravado na mesma transação da mudança, ambos são confirmados ou desfeitos juntos. Isso é útil para documentar alterações efetivadas, mas exige outro mecanismo para tentativas que terminaram em rollback. Triggers de alteração de linhas também não registram consultas SELECT. Exemplo e limitações de audit triggers no PostgreSQL.
O custo depende do volume, dos índices e do conteúdo gravado. Há ainda o trabalho de acompanhar mudanças de esquema e de transmitir a identidade do usuário final: se todas as conexões usam a mesma conta técnica, o banco conhece essa conta, não necessariamente a pessoa que iniciou a operação.
Auditoria na aplicação e no ORM
Interceptadores, callbacks, listeners e bibliotecas de auditoria permitem gerar o histórico perto do código que manipula as entidades. O Hibernate Envers, por exemplo, mantém revisões das entidades configuradas para auditoria e permite consultar seu estado em uma revisão. Hibernate Envers.
Essa proximidade facilita acrescentar informações da sessão e do negócio, mas a cobertura depende dos caminhos que passam pela instrumentação. Scripts administrativos, integrações externas e operações em lote precisam ser verificados separadamente. Também é necessário definir o momento da gravação: um callback executado antes do commit não comprova que a operação foi confirmada.
Tabelas temporais com versionamento de sistema
As tabelas temporais com versionamento de sistema, previstas no SQL:2011, transferem ao banco parte da manutenção do histórico. SQL Server e MariaDB oferecem esse recurso, com mecanismos para consultar versões anteriores dentro do histórico preservado. A configuração das tabelas, a retenção e as limitações da implementação continuam fazendo parte do projeto. Temporal tables no SQL Server e system-versioned tables no MariaDB.
O suporte varia entre produtos e versões. No PostgreSQL 18, por exemplo, system-versioned tables aparece entre os recursos SQL não implementados nativamente, portanto, obter comportamento semelhante exige uma solução adicional. Recursos não suportados no PostgreSQL 18.
O período registrado pelo banco tem uma semântica própria. No SQL Server, o versionamento usa o instante de início da transação, e versões de duração zero exigem atenção nas consultas, portanto, uma consulta temporal não deve ser apresentada como um registro universal de cada instante intermediário. Autor, justificativa e intenção de negócio também precisam de metadados complementares. Funcionamento das tabelas temporais e limitações do recurso.
Tempo de validade e modelagem bitemporal
 Diagrama de grafo bitemporal: tempo válido e tempo de sistema
O momento em que uma informação foi registrada pode ser diferente daquele em que ela passou a valer para o negócio. Em um exemplo hipotético, uma condição contratual pode valer desde o dia 1º e ser cadastrada apenas no dia 10. Para investigar uma decisão tomada no dia 5, interessa saber tanto a vigência posteriormente reconhecida quanto a informação que o sistema possuía naquela ocasião.
A modelagem bitemporal preserva esses dois eixos: tempo de sistema e tempo de validade no domínio. Ela permite tratar correções retroativas sem confundir a data de registro com a vigência do fato, embora exija consultas e regras de atualização mais cuidadosas. Tabelas bitemporais no MariaDB.
Change Data Capture
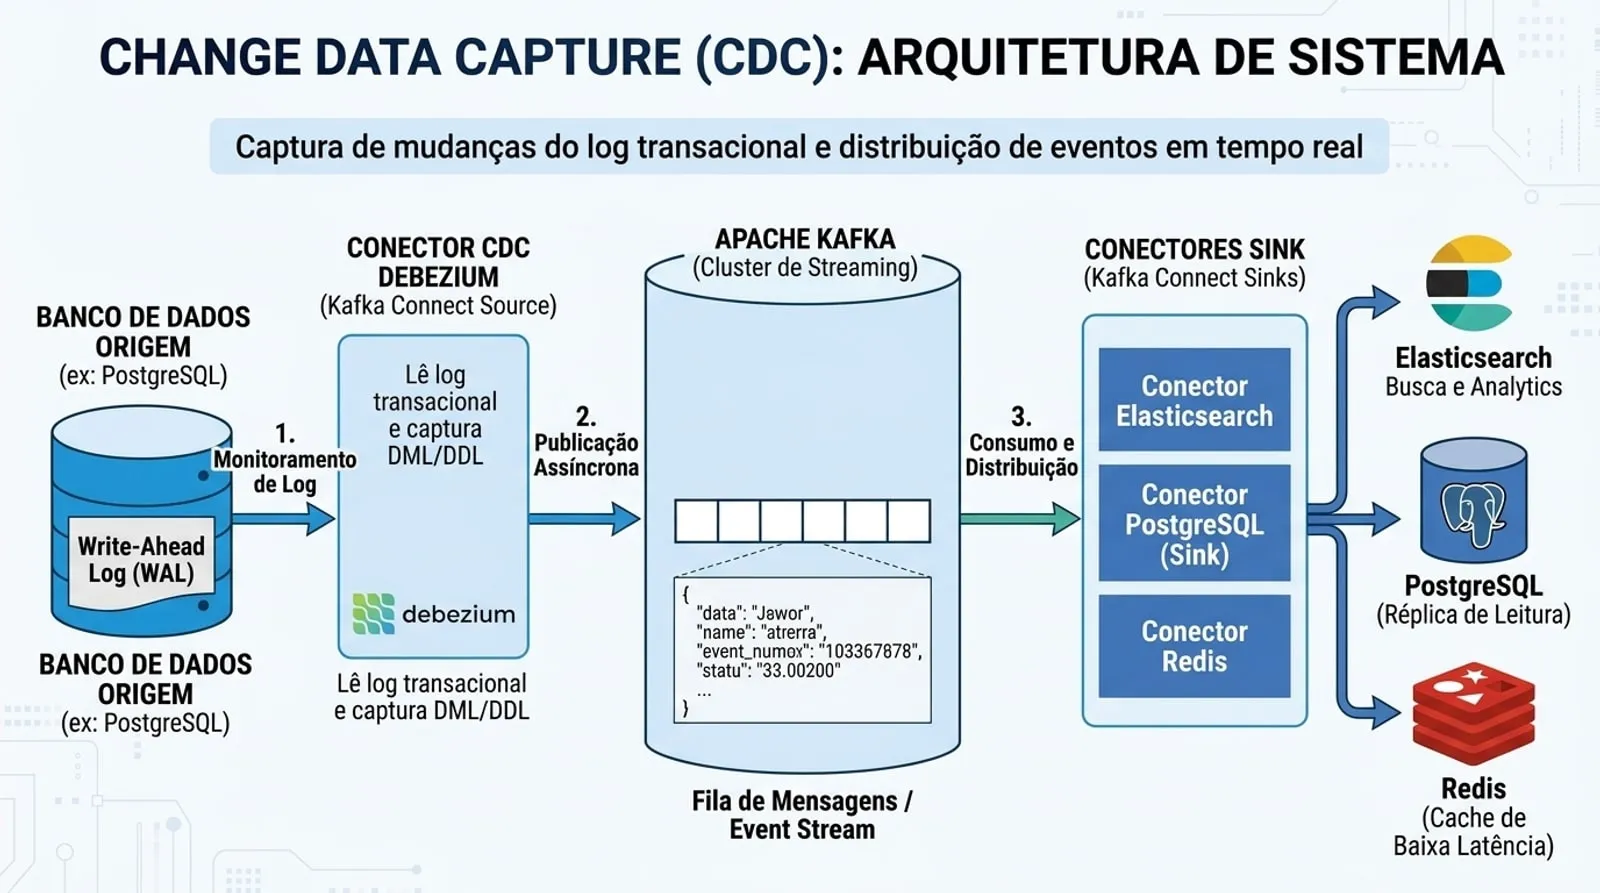 Change Data Capture, ou CDC, captura mudanças para disponibilizá-las a outros consumidores
Em implementações baseadas no log transacional, conectores como os do Debezium leem alterações persistidas e as publicam em um fluxo que pode alimentar repositórios de auditoria e plataformas analíticas. O conector PostgreSQL utiliza decodificação lógica do WAL. Conector PostgreSQL do Debezium.
Esse processamento pode ocorrer de forma assíncrona, mas ainda consome recursos, então é preciso acompanhar atraso, retenção do log de origem, disponibilidade do conector e possíveis duplicações na recuperação de falhas. A configuração também determina quais tabelas e valores anteriores ficam disponíveis. Um snapshot inicial descreve o estado encontrado, sem recuperar automaticamente todas as alterações anteriores à captura.
CDC ajuda a transportar evidências das mudanças cobertas, portanto, consultas, tentativas negadas e justificativas de negócio exigem fontes adicionais. Para ligar uma alteração à ação que a originou, a aplicação precisa fornecer contexto correlacionável.
Eventos de negócio e entrega confiável
Logs estruturados e eventos de domínio
Um evento como FaturaAprovada comunica um resultado de negócio com mais precisão do que uma mensagem genérica de atualização. Ele pode identificar a fatura, o responsável, a versão aprovada e a justificativa informada. Para manter a interpretação correta, eventos de solicitação, aprovação e falha devem ter significados distintos e ser emitidos nos momentos correspondentes. Padrão Domain Event.
Logs estruturados facilitam pesquisa e correlação, mas a escolha de um formato JSON ou de uma plataforma centralizada não define, sozinha, as garantias da trilha. O contrato deve estabelecer quais eventos são obrigatórios, quais campos podem ser omitidos e como tratar falhas de gravação.
Transactional Outbox e consumidores idempotentes
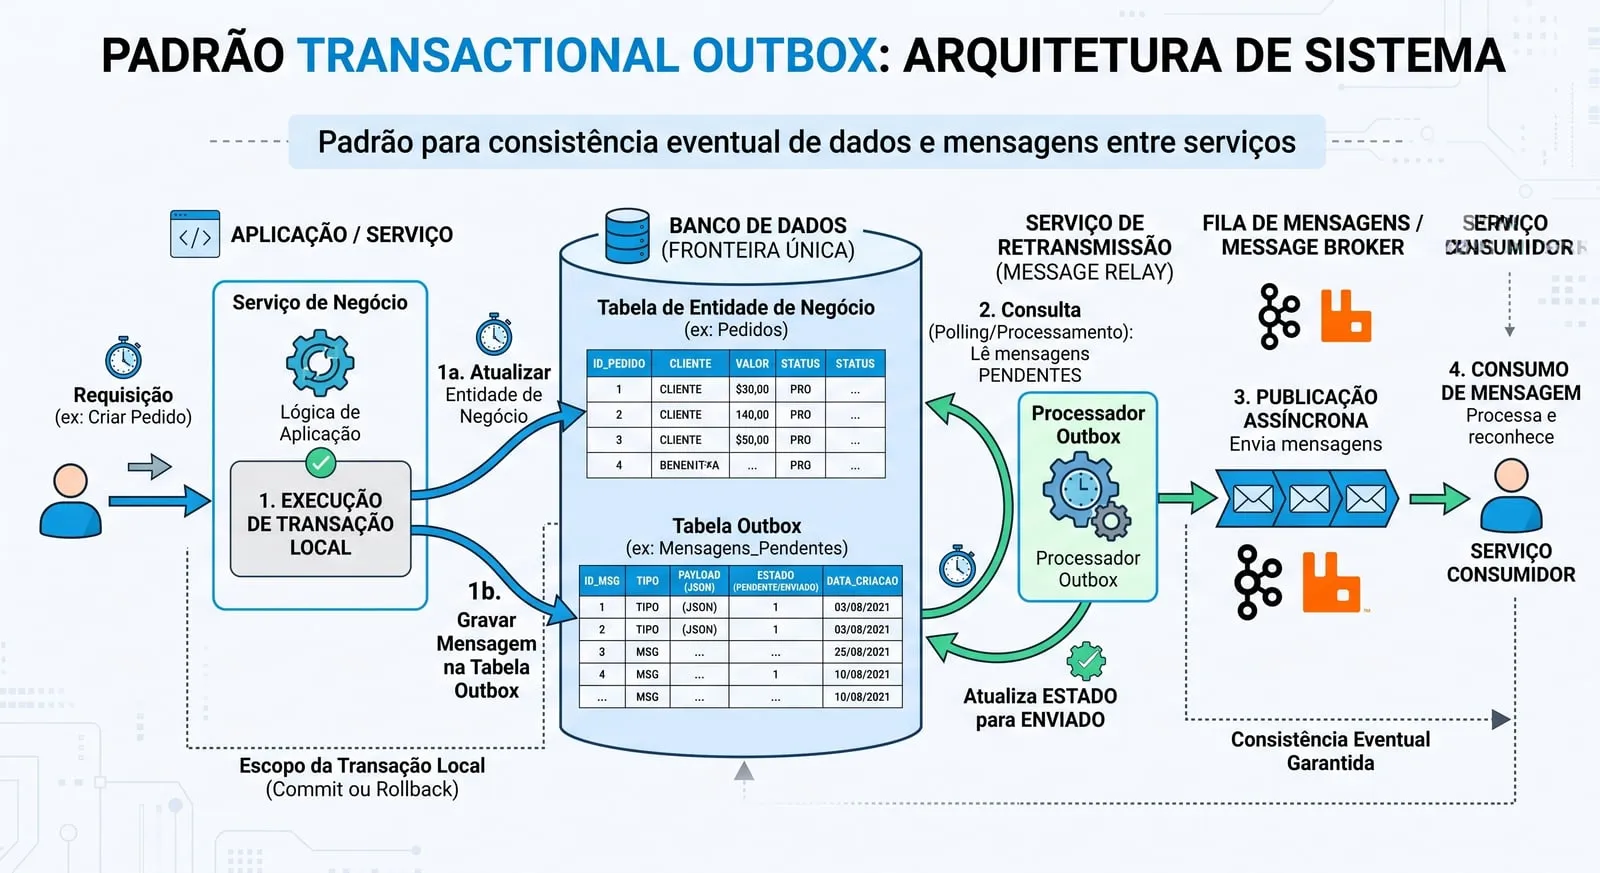 Padrão transacional outbox: arquitetura de sistema
Quando uma transação altera o banco e o código tenta publicar um evento em seguida, uma falha entre as duas operações pode deixar a alteração sem a mensagem correspondente. O padrão Transactional Outbox reduz esse problema ao gravar a mudança e o evento pendente na mesma transação local, e um publicador separado encaminha os registros confirmados. Transactional Outbox.
O publicador pode reenviar uma mensagem após uma falha. Por isso, o consumidor precisa reconhecer repetições, geralmente por um identificador estável. Uma inbox, ou tabela de mensagens processadas, pode registrar esse identificador na mesma transação do efeito local. Essa coordenação evita que a repetição produza uma segunda alteração, sem exigir a promessa de entrega exatamente uma vez em todo o sistema. Idempotent Consumer.
A limpeza da outbox deve respeitar a confirmação de entrega e a política de recuperação. Ela funciona como mecanismo de publicação, portanto, a retenção de longo prazo da evidência precisa ser definida para o destino de auditoria.
Logs de eventos e retenção nos brokers
Plataformas como Apache Kafka podem distribuir eventos e permitir que consumidores retomem o processamento a partir de posições anteriores. Essa possibilidade depende do conteúdo ainda preservado. Políticas de retenção podem remover segmentos, e a compactação por chave pode eliminar valores anteriores que seriam necessários para reconstituir todas as mudanças. Retenção e compactação no Apache Kafka.
Ao usar esse fluxo como fonte de auditoria, é preciso compatibilizar retenção, configuração de limpeza e capacidade de recuperação dos consumidores. Também convém preservar a posição de origem de cada evento no destino, para investigar lacunas e reprocessamentos. A capacidade de reconstruir o último estado de uma entidade não implica a preservação de toda a sua trajetória.
Event Sourcing
 Abstração de event sourcing
No Event Sourcing, a sequência persistida de eventos é a fonte de verdade do domínio. O estado pode ser reconstruído pela aplicação desses eventos, enquanto projeções e snapshots permitem consultar ou carregar esse estado sem reproduzir todo o histórico a cada operação. Os eventos representam fatos aceitos pelo domínio, sendo assim, não precisam corresponder a cada clique ou comando recebido. Event Sourcing, de Martin Fowler.
A disponibilidade dessa sequência favorece a investigação, mas o padrão não garante proteção criptográfica, identidade confiável ou retenção adequada. Essas propriedades dependem do armazenamento e dos controles de acesso. Evolução dos eventos, concorrência e compatibilidade do código de reconstrução também precisam ser planejadas. Event Sourcing no Azure Architecture Center.
Uma correção normalmente acrescenta novos fatos ao histórico. Durante um replay, efeitos externos precisam ser controlados para que reconstruir o estado não envie novamente uma cobrança ou notificação. Por esse custo de implementação, a adoção deve acompanhar necessidades do domínio que justifiquem manter os eventos como fonte primária.
CQRS e projeções para consulta
CQRS separa os modelos de escrita e leitura. Essa separação permite construir consultas específicas para investigação, como uma linha do tempo por entidade ou um relatório por responsável, inclusive em sistemas que utilizam Event Sourcing. CQRS, isoladamente, não mantém um histórico: essa responsabilidade continua na fonte que alimenta as projeções. Padrão CQRS.
Quando a atualização é assíncrona, a consulta deve informar até qual ponto os eventos foram processados. Um resultado ausente pode significar atraso da projeção, e essa possibilidade precisa ser distinguida da ausência da operação.
Acessos, segurança e administração
Auditoria de comandos e consultas no banco
Recursos nativos de auditoria e extensões específicas registram atividades como consultas, alterações de estrutura e modificações de permissões. O pgAudit, por exemplo, permite selecionar classes de comandos e objetos para auditoria no PostgreSQL. Esse registro complementa o histórico de linhas, pois documenta atividades que podem não modificar dados de negócio. Documentação do pgAudit.
A escolha dos eventos deve considerar volume e sensibilidade. Registrar um comando não equivale a manter uma cópia de cada linha retornada, e uma consulta atribuída à conta compartilhada da aplicação continua exigindo correlação para identificar o usuário final. Para exportações, convém registrar também o escopo solicitado e o resultado da geração ou entrega do arquivo.
Identidade, permissões e infraestrutura
A investigação pode depender de eventos anteriores à ação de negócio: autenticação, concessão de privilégios, uso de uma conta de serviço ou mudança de configuração. Logs de infraestrutura ajudam a reconstruir essa sequência, desde que os recursos necessários estejam incluídos na política de coleta.
No Kubernetes, a política de auditoria determina quais requisições à API são registradas e com que nível de detalhe. No AWS CloudTrail, eventos de dados, como determinadas operações sobre objetos, precisam ser configurados, e sua coleta não deve ser presumida a partir da existência de uma trilha. Auditoria no Kubernetes e eventos de dados no CloudTrail.
Referências à versão implantada, às mudanças de configuração e às aprovações administrativas ajudam a conectar essas evidências ao comportamento da aplicação. A mesma lógica vale para intervenções emergenciais: motivo, autorização e ações executadas precisam permanecer identificáveis, inclusive quando alguém desabilita ou modifica a própria auditoria.
Execução de processos e decisões
Rastreamento distribuído
 Painel de rastreamento distribuído
O rastreamento distribuído conecta trechos de execução, chamados spans, por meio de um contexto propagado entre componentes. OpenTelemetry fornece mecanismos para instrumentar e correlacionar esses sinais, portanto, ferramentas como Jaeger e Zipkin permitem explorar os rastros coletados. Propagação de contexto no OpenTelemetry.
Um trace_id identifica um rastro técnico. Já o identificador de um processo de negócio pode precisar sobreviver por dias e relacionar várias requisições e traces. Por isso, vale preservar ambos, além de identificar o evento ou comando que causou uma ação subsequente.
A cobertura do trace depende da instrumentação, e a amostragem pode descartar execuções. Decisões internas só aparecem quando foram registradas. Para eventos obrigatórios de auditoria, a arquitetura precisa oferecer persistência compatível com o requisito de completude, mesmo quando a observabilidade trabalha com amostras. Amostragem no OpenTelemetry.
Máquinas de estado, workflows e tarefas humanas
Uma máquina de estado torna explícitas as transições permitidas de um processo. Para auditá-la, o projeto pode registrar o estado de origem, o estado de destino, o evento disparador e o responsável pela transição. Em fluxos longos, motores de workflow acrescentam persistência e coordenação, sendo assim, no Temporal, por exemplo, o histórico de eventos sustenta a recuperação da execução após falhas. Events and Event History no Temporal.
O histórico disponível varia conforme o produto, a modalidade e a configuração. No AWS Step Functions, workflows Standard mantêm histórico de execução no serviço, enquanto workflows Express dependem de logs para essa visualização, e a documentação informa que a entrega desses logs ao CloudWatch ocorre em melhor esforço, sem garantia de completude. Histórico e logs no Step Functions.
Nas aprovações humanas, a decisão deve ser vinculada à versão exata do documento ou dos dados apresentados, preservando atribuições, delegações e reaberturas. Se o processo exige que solicitante e aprovador sejam pessoas diferentes, a trilha deve permitir verificar essa condição. Retenção e exportação do histórico precisam acompanhar o prazo da investigação, que pode ultrapassar a vida operacional do workflow.
Sagas, compensações e reprocessamentos
Uma saga coordena uma sequência de transações locais e, quando necessário, executa ações compensatórias. Ela pode ser conduzida por um orquestrador ou pela troca de eventos entre serviços. Para auditoria, interessa relacionar cada etapa ao processo e distinguir a operação inicial de sua compensação. Padrão Saga.
Compensar um efeito pode produzir uma nova operação de negócio, como um estorno, sem apagar a operação original. O histórico deve permitir acompanhar tentativas, resultados, timeouts e intervenções manuais. Também convém preservar o vínculo entre uma execução malsucedida e seu reprocessamento, para que o sucesso posterior não esconda a falha anterior.
Quando há efeitos externos, o identificador fornecido pelo serviço chamado e o estado de confirmação ajudam a acompanhar o resultado. Um timeout pode deixá-lo desconhecido para quem fez a chamada, potanto, esse estado precisa de reconciliação antes de ser tratado como sucesso ou falha definitiva.
Registros de decisão e versões de regras
Para explicar uma decisão automatizada, o resultado precisa ser relacionado às informações utilizadas e à versão da regra aplicada. O Open Policy Agent oferece decision logs com dados como entrada, resultado, identificador da decisão e revisão do conjunto de políticas, além de mecanismos para remover informações sensíveis antes do envio. Decision logs no OPA.
O mesmo raciocínio orienta decisões de negócio: registrar a versão da regra e as referências às entradas permite investigar por que duas solicitações semelhantes tiveram resultados diferentes. Se houver um modelo de aprendizado de máquina, a proposta deve incluir sua versão, a configuração relevante e a saída efetivamente produzida. A possibilidade de reproduzir o resultado depende também das entradas e do comportamento dos componentes externos, por isso precisa ser avaliada separadamente da existência do registro.
Mineração de processos e verificação de conformidade
Com eventos associados a instâncias de processo, é possível analisar os caminhos executados e compará-los ao fluxo esperado. A mineração de processos ajuda a investigar desvios e gargalos, enquanto formatos como XES permitem intercambiar registros entre ferramentas. IEEE Task Force on Process Mining: XES.
Essa análise depende da qualidade dos eventos recebidos. A falta de uma etapa no conjunto analisado pode indicar tanto um desvio real quanto uma falha de captura, portanto, antes de concluir que uma aprovação foi pulada, é necessário verificar a cobertura da fonte.
Histórico analítico, arquivos e origem dos dados
Slowly Changing Dimensions e Data Vault
Em data warehouses, Slowly Changing Dimensions do tipo 2 preservam mudanças por meio de novas linhas para uma mesma entidade, com chaves próprias e períodos de vigência. Isso permite relacionar fatos ao contexto histórico correspondente, como a classificação de um cliente na época de uma operação. SCD tipo 2, do Kimball Group.
Data Vault organiza o histórico de atributos em estruturas chamadas satélites, relacionadas às entidades e aos seus vínculos. Metadados de carregamento e origem ajudam a identificar de onde veio uma versão e quando ela entrou na plataforma. Satélites no AutomateDV.
Esses modelos preservam o histórico que receberam. Uma extração periódica que observa apenas o estado atual pode perder alterações intermediárias, e para cobri-las, é necessário capturá-las na origem ou receber um fluxo que as contenha. Histórico analítico e auditoria transacional precisam ter suas granularidades explicitadas.
Snapshots, time travel e versionamento de arquivos
Snapshots e versões anteriores ajudam a recuperar estados conhecidos. No Delta Lake, consultas por time travel dependem da preservação dos arquivos de dados e do log necessários à versão solicitada. Em armazenamento de objetos, o versionamento permite conservar diferentes versões de um arquivo. Time travel e retenção no Delta Lake e versionamento de objetos no S3.
Para uma investigação, cada arquivo ou snapshot deve estar ligado à operação que o produziu, ao seu identificador de versão e às aprovações pertinentes. Backups contribuem para a recuperação, mas intervalos entre cópias podem ocultar mudanças intermediárias. A justificativa e a autoria de uma alteração continuam exigindo registros próprios.
Linhagem e proveniência
A linhagem descreve como conjuntos de dados participam de transformações. O OpenLineage organiza essas informações em jobs, execuções e datasets de entrada e saída, com extensões para metadados como versão do código e qualidade dos dados. Essa estrutura ajuda a investigar de qual processamento veio um resultado. Modelo do OpenLineage.
A proveniência também pode representar as entidades, atividades e agentes envolvidos na produção de uma informação, como propõe a família PROV do W3C. A granularidade deve acompanhar a pergunta de auditoria: conhecer a origem de uma tabela não explica necessariamente a derivação de cada campo ou registro. Visão geral do W3C PROV.
Livros de lançamentos em domínios financeiros
Em sistemas financeiros, livros de lançamentos com partidas dobradas registram débitos e créditos associados a uma transação, permitindo verificar relações de equilíbrio entre contas. Essa modelagem oferece controles específicos para a movimentação de valores e deve ser ligada às autorizações e aos eventos que originaram cada lançamento. Partidas dobradas na documentação do TigerBeetle.
O equilíbrio dos lançamentos não comprova que uma transação foi autorizada. Da mesma forma, o termo ledger também aparece em recursos de integridade criptográfica, que têm outra finalidade. O projeto precisa dizer qual dessas propriedades está oferecendo.
O que torna a evidência utilizável e confiável ?
Um contrato para os registros
Os mecanismos anteriores produzem registros diferentes. Para conectá-los, proponho um contrato comum com campos obrigatórios por tipo de evento, evitando exigir informações que não existem em determinados contextos.
- Identificação: ID estável do evento, tipo, origem e versão do esquema
- Responsabilidade: Identidade autenticada, conta executora e delegação, quando houver
- Objeto: Entidade, versão afetada e organização ou tenant ao qual pertence
- Ação e resultado: Operação solicitada, etapa alcançada, sucesso, negativa, falha ou resultado ainda desconhecido
- Tempo: Instante da ocorrência e instante de observação ou ingestão
- Correlação: IDs do processo, da requisição, do trace e do evento causador, quando aplicáveis
- Contexto: Justificativa, regra utilizada, referência da aprovação e versão da aplicação
- Evidência: Valores necessários, diferenças ou referências a conteúdos preservados
Separar ocorrência e observação ajuda a reconhecer atrasos de coleta, portanto, essa distinção aparece também no modelo de logs do OpenTelemetry. A ordem causal exige informações adicionais, porque horários de máquinas diferentes podem divergir. Convém padronizar os timestamps em UTC, preservar a precisão disponível e monitorar a sincronização dos relógios. Sequências por entidade e identificadores de transação ajudam a reconstruir a ordem dentro das garantias oferecidas por cada fonte. Modelo de dados de logs do OpenTelemetry.
Para atribuição de responsabilidade, a identidade deve vir de um contexto autenticado e controlado. Um nome enviado livremente no corpo da requisição é apenas uma declaração do remetente. Em operações delegadas, preservar quem iniciou a ação e qual identidade a executou evita atribuir toda a atividade à conta técnica intermediária.
Escrita por acréscimo e armazenamento WORM
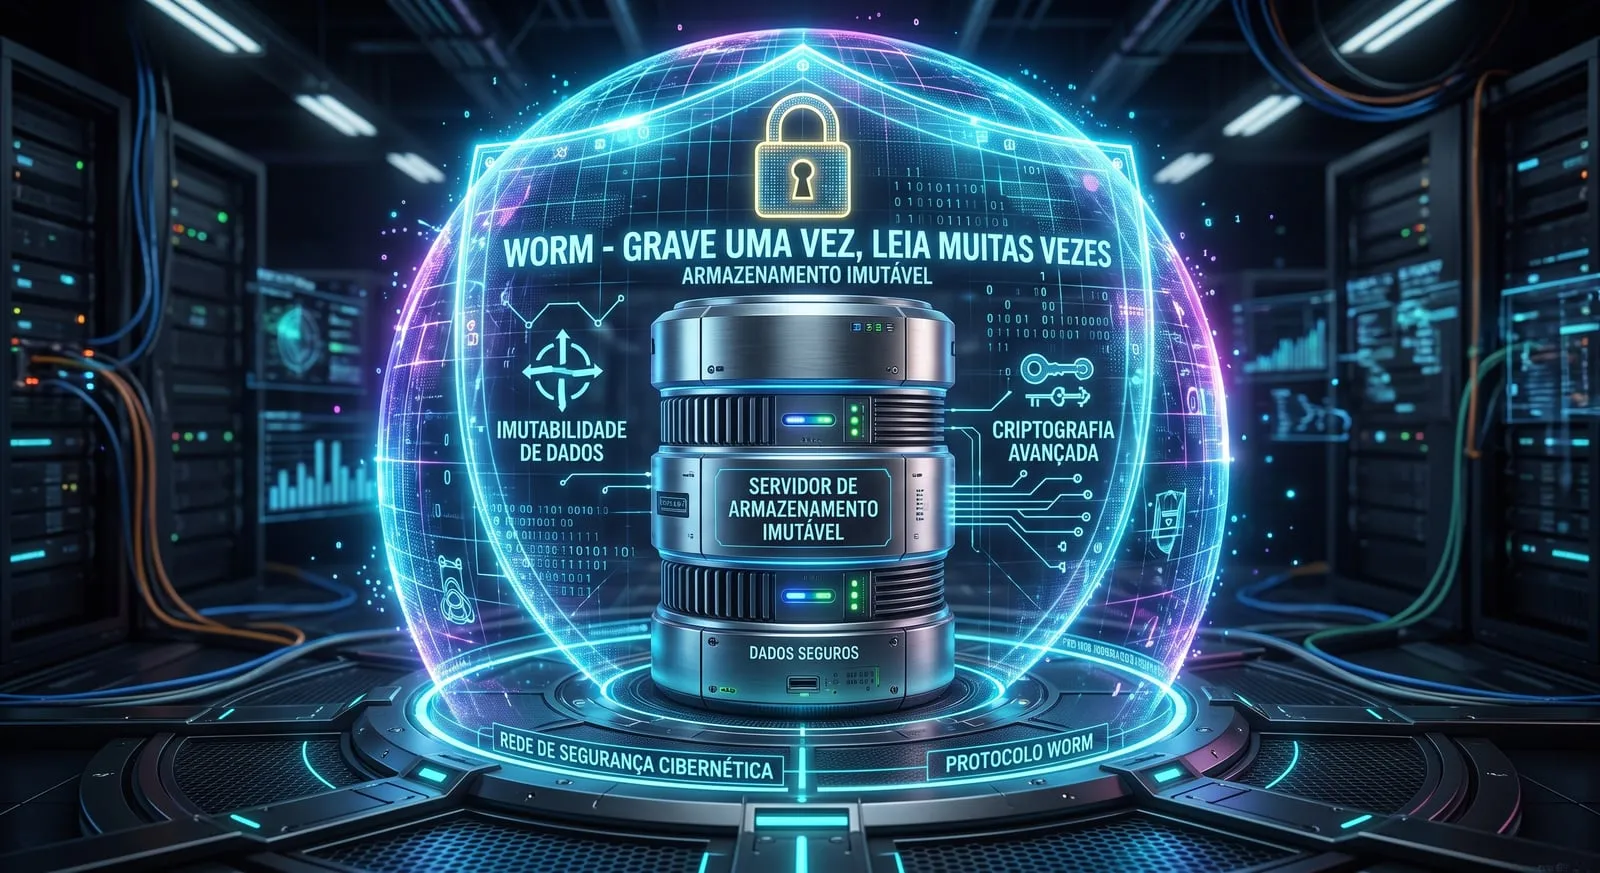 Escrita por acréscimo e armazenamento WORM
Um repositório append-only aceita novos registros e restringe a alteração dos existentes. A força dessa proteção depende de quem consegue modificar permissões ou acessar o armazenamento por outros caminhos. Separar as permissões de produção, consulta e administração da trilha reduz a concentração de privilégios, contudo, em sistemas com múltiplos tenants, o isolamento também precisa alcançar as consultas e exportações do histórico.
Armazenamento WORM, de write once, read many, acrescenta proteção contra sobrescrita e exclusão durante a retenção configurada. No S3 Object Lock, os modos Governance e Compliance oferecem garantias diferentes: o primeiro permite exceções a usuários autorizados, enquanto o segundo impõe restrições mais fortes à versão protegida. Essas diferenças devem orientar a escolha. Funcionamento do S3 Object Lock.
Detecção de adulteração e verificação criptográfica
Encadeamentos de hashes e assinaturas digitais podem apoiar a verificação da integridade dos registros preservados. O SQL Server Ledger, por exemplo, oferece estruturas verificáveis a partir de resumos criptográficos. Para que a verificação tenha valor contra um administrador comprometido, as referências usadas na comparação precisam de proteção independente e quem consegue reescrever os dados e os resumos pode comprometer a evidência. Visão geral do Ledger e proteção dos digests.
Essa verificação precisa fazer parte da operação, com resultados preservados e falhas investigadas, e seu alcance deve estar descrito.
A integridade do que foi armazenado não demonstra, por si só, que todos os fatos foram capturados ou que o conteúdo era verdadeiro na origem.
A atribuição de autoria depende ainda do controle das identidades e das chaves utilizadas.
Retenção, privacidade e acesso ao histórico
O prazo de retenção precisa considerar a finalidade e as obrigações aplicáveis. No caso de dados pessoais sujeitos à LGPD, o princípio da necessidade e as regras de término do tratamento e conservação precisam entrar no desenho. A política deve tratar também cópias, exportações e repositórios secundários, sem presumir um prazo único para todos os eventos. LGPD, especialmente arts. 6º, 15 e 16.
Os valores de senhas, tokens de acesso e chaves secretas devem ficar fora dos logs. Dados pessoais e conteúdos sensíveis exigem seleção, mascaramento ou referências com acesso controlado. A proteção deve considerar tanto o transporte quanto o armazenamento, com criptografia e gestão de chaves compatíveis com a sensibilidade e a retenção dos registros. A OWASP também recomenda proteger os registros contra manipulação e restringir o acesso à infraestrutura de logging. OWASP Logging Cheat Sheet.
Como critério de projeto, a política deve prever arquivamento, suspensão de descarte quando aplicável e eliminação autorizada. Para a exportação de evidências, convém preservar o recorte consultado, a origem, os responsáveis e verificações de integridade, de modo que o material possa ser examinado posteriormente. A consulta à própria trilha também deve ser auditável.
Perdas, falhas e capacidade de investigação
A operação precisa observar o caminho entre geração e preservação, acompanhando atrasos, filas, erros de gravação e interrupções de coleta. A reconciliação com registros de negócio ou outras fontes independentes ajuda a encontrar inconsistências que o monitoramento do destino não revela. Uma sequência contínua nesse repositório não detecta necessariamente um evento que nunca chegou a ser produzido.
A política para indisponibilidade merece uma decisão explícita. Operações cuja evidência seja obrigatória podem exigir bloqueio ou um mecanismo durável de contingência antes da confirmação. Outros contextos podem admitir continuidade com perda delimitada, desde que esse comportamento seja conhecido e monitorado. Um buffer apenas em memória não oferece a mesma proteção de uma gravação durável.
A gestão dos logs também envolve análise, resposta e responsáveis por investigar anomalias. Centralização e integração com ferramentas de segurança ajudam nesse trabalho, mas dependem de coleta e retenção adequadas. NIST SP 800-92: gestão de logs de segurança.
Antes de considerar a solução pronta, é preciso verificar o comportamento sob falhas, indisponibilidade de rede, falta de espaço e entradas malformadas, incluindo tentativas de inserir conteúdo que falsifique linhas de log. A OWASP inclui esses cenários na verificação dos mecanismos de logging. Verificação de logs na OWASP.
O mais importante é isto aqui cara: Como combinar de fato as abordagens ?
A escolha parte da pergunta e das garantias exigidas, sendo assim, estas combinações abaixo sintetizam os mecanismos discutidos como orientação de arquitetura e precisam ser validadas no ambiente em que serão usadas.
- Identificar criação e última alteração. Mecanismos a considerar: Colunas de auditoria. Complemento a verificar: Histórico completo, se necessário.
- Consultar versões anteriores de entidades. Mecanismos a considerar: Tabelas de histórico, ORM ou tabelas temporais. Complemento a verificar: Autoria, motivo e cobertura dos caminhos de escrita.
- Investigar correções retroativas. Mecanismos a considerar: Modelagem bitemporal. Complemento a verificar: Semântica da vigência e do momento de registro.
- Distribuir mudanças do banco. Mecanismos a considerar: CDC. Complemento a verificar: Contexto, retenção de origem e recuperação de falhas.
- Preservar fatos de negócio. Mecanismos a considerar: Eventos de domínio e outbox. Complemento a verificar: Persistência durável, deduplicação e retenção no destino.
- Reconstruir o domínio a partir de eventos. Mecanismos a considerar: Event Sourcing. Complemento a verificar: Evolução dos eventos e controle de efeitos no replay.
- Auditar acessos e administração. Mecanismos a considerar: Auditoria do banco, identidade e infraestrutura. Complemento a verificar: Usuário final, escopo de coleta e ações privilegiadas.
- Investigar processos longos. Mecanismos a considerar: Histórico de workflow e transições. Complemento a verificar: Aprovações humanas, versões e exportação do histórico.
- Acompanhar transações distribuídas. Mecanismos a considerar: Sagas e correlação. Complemento a verificar: Compensações e resultados externos desconhecidos.
- Explicar decisões automatizadas. Mecanismos a considerar: Registros de decisão. Complemento a verificar: Entradas, regra ou modelo utilizado e resultado.
- Rastrear transformações analíticas. Mecanismos a considerar: Linhagem, proveniência, SCD e Data Vault. Complemento a verificar: Granularidade, versões e cobertura da captura.
- Preservar e verificar evidências. Mecanismos a considerar: Controle de acesso, WORM e verificação criptográfica. Complemento a verificar: Retenção, referências independentes e testes de recuperação.
- Identificar criação e última alteração: Colunas de auditoria atendem a essa necessidade; avalie se também será necessário manter um histórico completo.
- Consultar versões anteriores de entidades: Tabelas de histórico, ORM ou tabelas temporais são opções. A cobertura precisa incluir autoria, motivo e os diferentes caminhos de escrita.
- Investigar correções retroativas: Modelagem bitemporal permite preservar os dois eixos de tempo, desde que estejam claras a semântica da vigência e a do momento de registro.
- Distribuir mudanças do banco: CDC pode transportar as alterações. O desenho precisa contemplar contexto, retenção na origem e recuperação de falhas.
- Preservar fatos de negócio: Eventos de domínio e outbox ajudam a registrar e publicar esses fatos, com persistência durável, deduplicação e retenção no destino.
- Reconstruir o domínio a partir de eventos: Event Sourcing atende a essa proposta, com planejamento para a evolução dos eventos e controle dos efeitos externos durante o replay.
- Auditar acessos e administração: Auditoria do banco, identidade e infraestrutura precisam ser relacionadas ao usuário final, ao escopo de coleta e às ações privilegiadas.
- Investigar processos longos: Histórico de workflow e transições deve acompanhar as aprovações humanas, as versões utilizadas e a possibilidade de exportar o histórico.
- Acompanhar transações distribuídas: Sagas e correlação permitem relacionar as etapas, incluindo compensações e resultados externos ainda desconhecidos.
- Explicar decisões automatizadas: Registros de decisão devem preservar as entradas, a regra ou o modelo utilizado e o resultado produzido.
- Rastrear transformações analíticas: Linhagem, proveniência, SCD e Data Vault contribuem conforme a granularidade, as versões e a cobertura da captura.
- Preservar e verificar evidências: Controle de acesso, WORM e verificação criptográfica precisam acompanhar a política de retenção, as referências independentes e os testes de recuperação.
No exemplo da fatura, uma arquitetura possível grava a mudança de status e um evento de aprovação na mesma transação, usando outbox para a publicação, com isso, o histórico da entidade guarda os valores necessários à comparação, e o registro da decisão identifica a regra e a versão da fatura aprovada. O workflow relaciona as etapas, e um trace ajuda a investigar chamadas técnicas. Se houver pagamento externo, sua confirmação ou resultado desconhecido permanece ligado ao processo. O repositório de auditoria aplica os controles de acesso, retenção e integridade definidos para esse conjunto de evidências.
Essa é uma proposta de composição, não uma exigência de implementar todas as tecnologias. Uma aplicação menor pode reunir várias responsabilidades no mesmo banco, desde que consiga demonstrar as garantias exigidas. A separação física passa a fazer sentido quando ajuda a cumprir requisitos de volume, disponibilidade ou independência administrativa.
Padrões de implementação e requisitos normativos
Os padrões de arquitetura descrevem maneiras de construir a solução. Referenciais de controle ajudam a definir o que será exigido e como isso será avaliado. A família Audit and Accountability do NIST SP 800-53, por exemplo, contempla geração e conteúdo dos registros, resposta a falhas, análise, timestamps, proteção e retenção. Ela pode orientar uma matriz que relacione requisito, mecanismo, responsável e evidência de verificação. NIST SP 800-53 Rev. 5.
Setores regulados acrescentam exigências próprias. A orientação da FDA sobre integridade de dados em boas práticas de fabricação de medicamentos é um exemplo de material voltado a um contexto específico, cuja aplicação não deve ser generalizada para qualquer software. FDA: Data Integrity and Compliance With Drug CGMP.
Conformidade exige mapear as obrigações aplicáveis ao sistema e verificar sua implementação. A presença de uma ferramenta, de um log imutável ou de um padrão de arquitetura não substitui essa avaliação.
Como avaliar a cobertura na prática
Um modo de tornar a cobertura verificável é cruzar operações relevantes com seus caminhos de execução: interface, API, importação, rotina agendada, integração, acesso direto e intervenção administrativa. Para cada combinação, devem existir uma expectativa de evidência e um procedimento de verificação.
Alguns cenários ajudam a revelar lacunas:
- uma alteração confirmada pode ser ligada ao autor, à versão anterior e ao seu contexto;
- uma tentativa negada permanece identificável, mesmo sem alteração de dados;
- uma falha antes do commit não aparece como operação concluída;
- a repetição de uma mensagem não produz um segundo efeito de negócio;
- uma indisponibilidade de coleta deixa um sinal detectável e permite a recuperação prevista;
- uma aprovação permanece vinculada ao conteúdo que foi apresentado ao aprovador;
- uma compensação ou correção conserva o vínculo com a operação original;
- registros antigos continuam interpretáveis após a evolução do esquema;
- o histórico arquivado pode ser recuperado e verificado dentro do prazo necessário;
- mudanças nas políticas de auditoria e acessos à evidência deixam seus próprios registros.
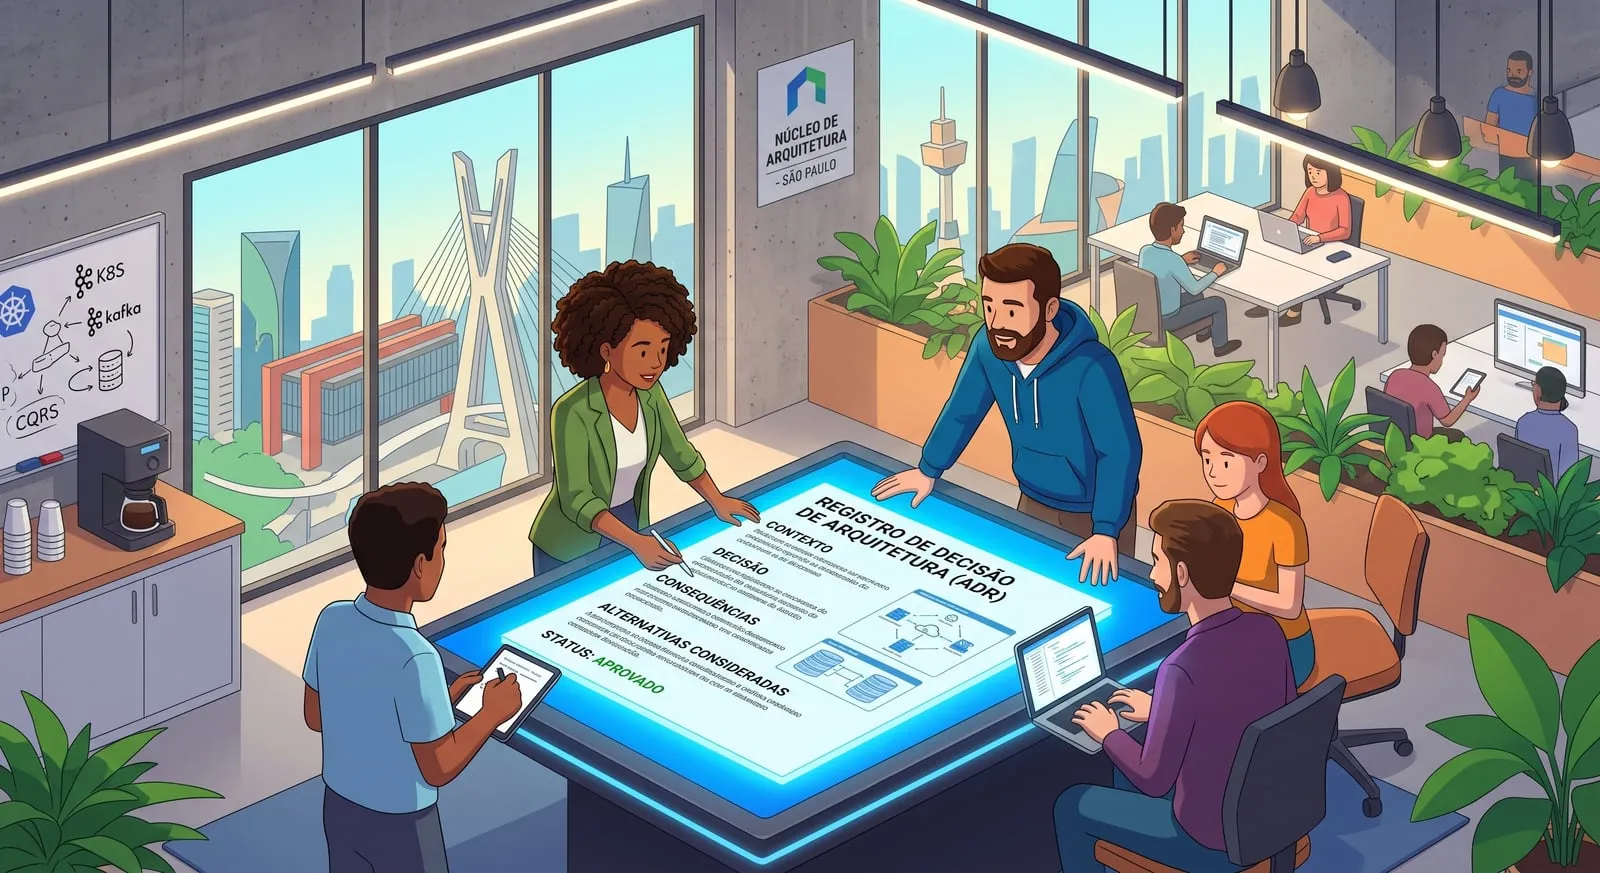 Registro de decisão de arquitetura (ADR)
Uma organização pode buscar 100% dos cenários definidos em seu escopo, mantendo explícitos os caminhos excluídos e os riscos aceitos. A medida útil é conseguir demonstrar quais acontecimentos podem ser reconstruídos, com que evidência e dentro de quais limites. Este escopo precisa ser revisto quando surgem novas operações, integrações ou formas de acesso, por isso eu particularmente, Murilo de Abreu Inácio, adoro alocar, inclusive, estas decisões e versionar junto ao projeto no formato de Registro de Decisão Arquitetônica (ADR), que é um documento curto que registra uma escolha técnica importante em um projeto de software, junto com seu contexto e suas consequências, portanto a equipe inteira consegue ter ciência do que foi decidio e porquê e como, detalhando as evidências e limites de cada auditoria.